이름을 더했을 때 무엇이 나아졌을까: 통합 판독과 제거 비교
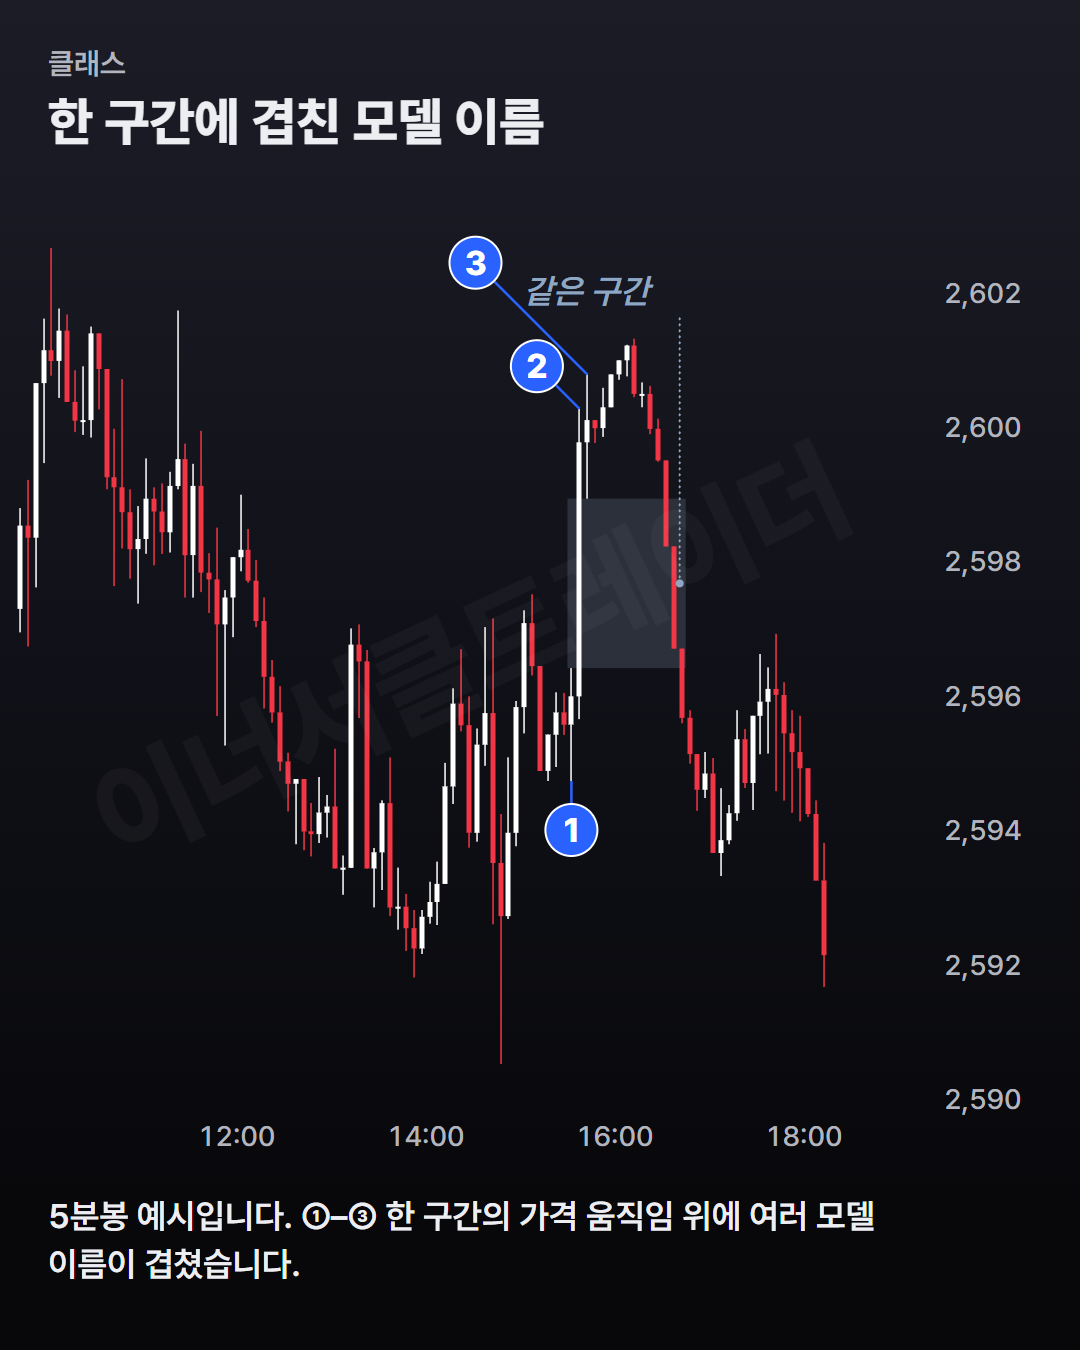
미국 주식 개장 직후 한 번의 급등락을 복기 표에 서로 다른 네 건으로 적어 놓았습니다. 차트에서 실제 일어난 움직임은 ①–③ 구간 하나뿐인데, 노트에 Venom, First Presented FVG(개장 구간에서 처음 조건을 충족한 세 봉의 가격 틈), Turtle Soup, Gauntlet 이름을 나란히 적고 각자 따로 세었기 때문입니다. 그중 결과가 좋았던 이름만 골라 성과로 적다 보면, 실제 매매 횟수와 기록이 완전히 어긋납니다.
새로 배운 배열 이름을 차트에 하나 더 얹으면 판단이 정교해진 기분이 듭니다. 하지만 정작 그 이름을 추가했을 때 어떤 후보를 새로 골랐는지, 아니면 원래 잡던 거래만 이름 바꿔 부른 것인지는 따져 보지 않습니다. 차트 위에 선과 상자만 늘어날수록 지금 어느 배열을 근거로 기다려야 하는지 오히려 흐려지고, 같은 장면을 둔 기록만 두 배, 세 배로 불어납니다. 어느 배열이 진짜 기준인지도 헷갈립니다.
한 세션에서 여러 전달 모델이 겹칠 때, 중복 집계를 막고 추가 개념의 실제 가치를 어떻게 검증해야 할까요?
멤버십으로 이어 읽기
팬딩 또는 레퍼럴 멤버십이 확인되면 이 글의 전문을 읽을 수 있습니다.
- 한 세션을 정보가 들어온 순서로 어떻게 복원할까요?
- M14와 M15의 규칙 카드는 무엇을 다르게 잠글까요?
- 같은 사건에는 왜 하나의 거래 ID만 붙일까요?
- 비용과 순서 미해결 봉은 장부에 어떻게 남길까요?
- 추가 개념을 뺀 비교는 왜 같은 기회 집합에서 할까요?
- 직접 해 보기: 오표기를 고치고 같은 판단을 재현해 볼까요?
- 풀이